
Je webshop heeft een nette categoriepagina voor hardloopschoenen. Daarnaast bestaan er honderden URL’s met filters, zoals maat, merk en kleur. In Search Console zie je dan de melding dat Google een andere canonieke pagina heeft gekozen. Dat voelt vreemd, want een filter toont toch andere producten?
Voor Google is het verschil vaak kleiner dan voor jou. Hieronder lees je hoe Google duplicaten herkent en waarom filterpagina’s zo snel in die categorie vallen. Ook lees je wat je eraan kunt doen.
In het kort
120 producten
Producten op de categoriepagina Hardloopschoenen
60
Producten bij het filter maat 42
positie6
Categoriepagina Loungesets op de ene dag
positie11
Filter-URL met teak op een andere dag
Hoe Google bepaalt wat een duplicaat is
Google vergelijkt niet alleen de zichtbare tekst. Het kijkt naar de hele pagina: de kopteksten, het menu, de technische opbouw en de producten. Pagina’s die sterk op elkaar lijken, worden samen in een cluster geplaatst. Uit dat cluster kiest Google één versie als canonieke pagina. Alleen die versie krijgt een kans in de zoekresultaten.
Stel dat je categoriepagina Hardloopschoenen 120 producten toont. Het filter maat 42 laat er 60 zien, met dezelfde H1, dezelfde introtekst en hetzelfde menu. De helft van de producten is gelijk en alle andere onderdelen zijn identiek. Voor een algoritme is dat geen nieuwe pagina, maar een variant van de bestaande.
Dit gebeurt dus niet omdat je iets fout hebt gekopieerd. Het gebeurt omdat het systeem gelijkenis meet en niet intentie. Jij weet dat een bezoeker met maat 42 iets anders zoekt. Google ziet dat pas als de pagina dat zelf duidelijk maakt.
“
Het gebeurt omdat het systeem gelijkenis meet en niet intentie.
Waarom filterpagina’s zo veel op de categoriepagina lijken
De meeste webshopsystemen maken van elke filtercombinatie een nieuwe URL. Die pagina erft bijna alles van de categorie. Dat levert vier overeenkomsten op die Google meeweegt.
Zelfde titel, andere URL
Een voorbeeld. Een shop in sneakers heeft de titel “Sneakers kopen | Shopnaam”. Kies je de kleur zwart, dan blijft die titel gelijk. De URL verandert, de titel niet, en ook de tekst blijft staan. Google ziet twee pagina’s met dezelfde boodschap en kiest er één.
Sortering maakt het nog sterker. Bij ?sort=prijsoplopend zijn de producten exact hetzelfde, alleen de volgorde verschilt. Dat is een bijna volledig duplicaat. Zulke URL’s kunnen in grote aantallen ontstaan, en elke nieuwe parameter vermenigvuldigt dat aantal.
Wat er misgaat als Google de verkeerde versie kiest
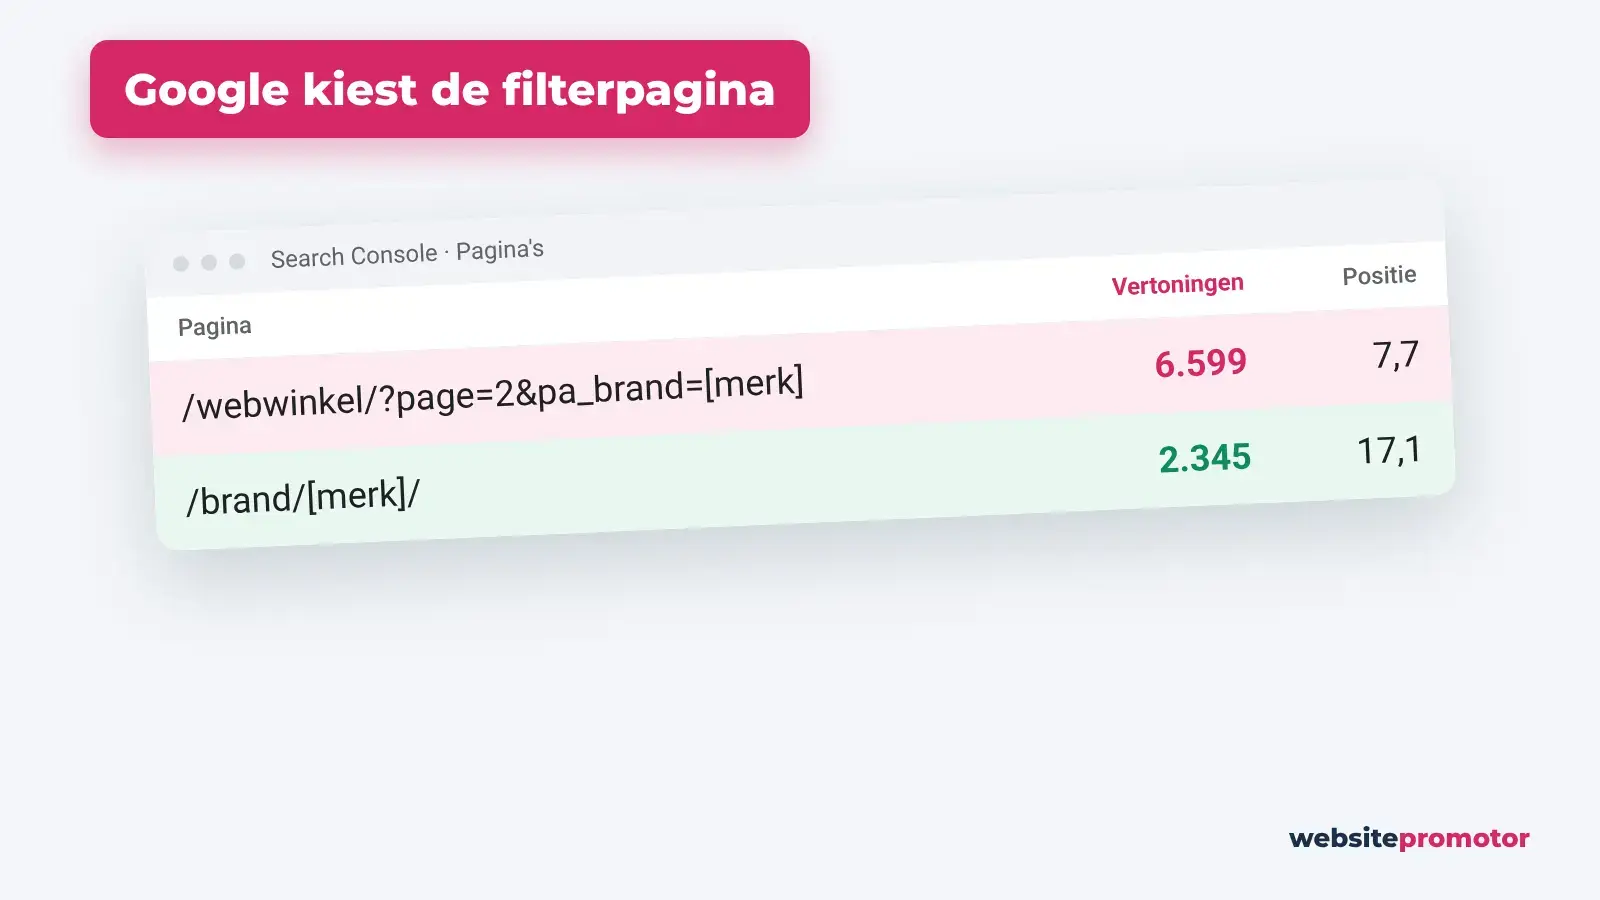
Soms kiest Google de filterpagina als canonieke versie. Dan zie je in de zoekresultaten ineens een pagina met drie producten in plaats van je hoofdcategorie. De bezoeker landt op een smalle selectie en haakt sneller af. Dat kost omzet, ook al blijft het verkeer even hoog.
Er zijn meer gevolgen die je merkt in de praktijk. Dit zijn de belangrijkste.
Linkwaarde en interne signalen worden over meerdere URL’s verdeeld. Googlebot besteedt tijd aan filter URL’s die niets toevoegen. Bij grote shops gaat dat ten koste van nieuwe producten. Je rapportages worden onbetrouwbaar, omdat posities tussen URL’s wisselen.
Schommelende posities in de praktijk
Een voorbeeld uit de praktijk. Een webshop in tuinmeubelen ziet zijn categorie Loungesets wekenlang schommelen. Op de ene dag staat de categoriepagina op positie 6. Op de andere dag staat een URL met ?materiaal=teak op positie 11. Er is geen update gedaan, maar Google twijfelt tussen twee bijna gelijke pagina’s.
Ook voor AI zoekmachines is dit een nadeel. Zij halen bronnen op en moeten bepalen welke pagina het antwoord het best onderbouwt. Versnipperde URL’s maken die keuze lastiger. Bij GEO, ons woord voor zichtbaarheid in AI zoekmachines, helpt één duidelijke pagina per onderwerp. Meer over die aanpak lees je op onze pagina over Generative Engine Optimization.
Wanneer een filterpagina wél een eigen pagina verdient
Niet elke filter is overbodig. Sommige filters sluiten aan op wat mensen echt intypen in Google. Zwarte hardloopschoenen heren is een goed voorbeeld. Daar zit zoekvolume achter en de bezoeker verwacht een gerichte selectie.
Zo’n pagina moet zich wel onderscheiden. Geef hem een eigen titel, een eigen H1 en een korte eigen tekst. Laat de URL stabiel zijn, zonder parameters in een willekeurige volgorde. Zorg dat de pagina in het menu of in interne links een logische plek heeft.
De tabel hieronder helpt bij de afweging per filtertype. Per type zie je het risico en de aanpak.
| Filtertype | Voorbeeld | Risico op duplicaat | Aanpak |
|---|---|---|---|
| Sortering | ?sort=prijs | Zeer hoog | Canonical naar de categorie en niet laten crawlen |
| Maat of kleur | ?maat=42 | Hoog | Canonical naar de categorie |
| Merk binnen categorie | /sneakers/nike/ | Laag als er zoekvraag is | Eigen pagina met eigen tekst |
| Meerdere filters gecombineerd | ?merk=nike&kleur=zwart&maat=42 | Zeer hoog | Niet indexeren en niet intern linken |
Het gaat dus niet om alles blokkeren. Het gaat om kiezen welke combinaties een eigen plek in de index verdienen.
Zo geef je Google duidelijke signalen
Google beslist zelf welke pagina canoniek wordt. Een canonical is een sterke hint, maar geen bevel. Je moet daarom alle signalen dezelfde kant op laten wijzen. Dat doe je in een paar stappen.
Zet op filter URL’s zonder zoekvraag een canonical naar de categoriepagina. Link intern alleen naar de schone categorie URL’s, niet naar parameter URL’s. Houd filter URL’s uit je XML sitemap. Geef pagina’s die je wel wilt laten ranken een eigen titel, H1 en tekst. Beperk het aantal combinaties dat een bezoeker kan maken, bijvoorbeeld tot twee filters tegelijk.
Robots.txt verbergt je canonical
Let op de volgorde van maatregelen. Blokkeer je een URL in robots.txt, dan leest Google de canonical op die pagina niet meer. Is de URL al geïndexeerd, dan blijft hij soms nog lang staan. Gebruik robots.txt dus vooral voor URL groepen die nooit in de index hoefden, zoals sorteervolgordes.
Controleer het resultaat in Search Console. Kijk bij de indexeringsrapporten naar de meldingen over duplicaten en alternatieve canonieke pagina’s. Gebruik ook de URL inspectie om te zien welke canonical Google heeft gekozen. Verschilt die van jouw keuze, dan zijn je signalen nog niet eenduidig.
Bij Websitepromotor zien we dit patroon vaak bij webshops die snel groeien. Technische keuzes uit het begin leveren later duizenden extra URL’s op. Via Citekick, ons eigen platform, plaatsen we zelfstandig technische en structurele verbeteringen en schrijven we de content voor pagina’s die een eigen plek verdienen. Onze consultants sturen en keuren dat werk. Wil je weten hoe wij de technische kant aanpakken? Dan helpen onze specialisten in technische SEO je graag verder.
Eén duidelijke pagina per zoekvraag
Google ziet een filterpagina als duplicaat omdat de pagina bijna alles deelt met de categorie. Titel, tekst, opbouw en producten komen overeen, en alleen de selectie verschilt. Zolang je pagina niet laat zien waarom hij anders is, kiest het systeem zelf een winnaar.
De oplossing begint met een keuze. Bepaal welke filters echt een zoekvraag bedienen en geef die een eigen gezicht. Laat de rest verwijzen naar de categorie. Zo worden je signalen eenduidig en blijft je belangrijkste pagina bovenaan staan.
Twijfel je welke filters in jouw shop een eigen pagina verdienen, of wil je dat laten uitzoeken? Bekijk dan hoe we werken bij SEO uitbesteden. Daar zie je wat een maandpakket bij Websitepromotor omvat.